「アイディア」に関する日記(7)

<前 次>

無題

刑事ドラマがあって、検事ドラマがあって、弁護士ドラマがあって、捜査官ドラマがあって、裁判官ドラマがあって、裁判員ドラマがあって、ふと思ったのです。
裁判をはじめとする法律関係のドラマに被告人ドラマや証人ドラマが見当たらないことに。
例えば、「俺は松田美文。被告人だ。今日も無実の罪で逮捕された。」みたいに始まって毎回無実の罪で起訴される被告人が主人公とか。
そしてドラマが進むに連れて起訴される罪状がどんどんエスカレートするとか。

最終回、巨大な組織の国家的犯罪の濡れ衣を着せられた松田美文、果たして無罪を勝ち取ることができるのか!
窃盗から始まり殺人にいたるまで数々の濡れ衣が、巨大な陰謀へと繋がっていく!!

意外といいと思うのですが、誰かやらないでしょうかねぇ。

無題

逆転裁判4のページを作りました。
まだ途中までしかクリアしていないので途中なりの内容で。

ゲーム記をリニューアルしようかと考えています。
今は各ゲームをハードごとに分類していますが、シリーズ作品やリメイク作品がマルチプラットフォーム展開していることが珍しくなく、ハードごとの分類だと不便な部分があるためです。
ただ、リニューアルしようかと「考えている」だけなので、実は今のところ実行に移す予定はありません。

無題

アンパンマンDBの最近のTOP10が機能しなくなっていたので修正しました。

それはそうとちょっとニコニ・コモンズについて。
今はランダムに並べる機能がないのでなんとかこっち側で実装したい。
まず、サーチ結果のページ内容から「件中」を含む行を抜き出し、その行内でbタグに囲まれた最初の数字、または「件中」より前にある最後の数字を抜き出す。
0~抜き出した数字-1の範囲の整数の乱数(R)を生成する。
(R)を30で割った整数部分に1を足すとページ番号(P)、あまりがページ内オフセット(O)となる。
次にアクセスするURLは「http://www.niconicommons.jp/search/~?page=(P)&…」だとわかる。
「<!--thumb start -->」と「<!--thumb end -->」で囲まれた部分が一つ一つの素材。
正規表現などを使ってこの部分を順次抜き出せば(O)の値を使って目的の、つまりランダムな素材が見つかる。
偏りのある乱数生成器とニコニ・コモンズのソート機能を使えば新しいものや人気の素材が出やすいようなランダムセレクトも作れる。
これを順次繰り返せばランダムに並べる機能も作れるというわけ。
コモンズサーバーへの負荷を考えるならば同じページへのアクセスは極力減らして一回のアクセスで必要な情報を全部取り出すようにしたい。

アンパンマンDBとTGscript

アンパンマンDBのユーザーIDシステムについて考えています。
ただユーザーごとにIDを与えるのは簡単なのです。
しかしユーザーにとってのユーザーIDを使う利益というものが今のところないのです。
実際のところ導入したい理由というのが、ユーザーごとの制限を加えたいということなのです。
なので、サイト全体に通用するIDを用いるTGscriptのユーザーIDと一本化しようかということを考えてみました。
そうすれば掲示板の利便性との兼ね合いでどうにかなるかと…。

無題

アンパンマンDBでリンク先をすばやく表示するためにリンク先のデータをキャッシュしておくというアイディアを以前に言っていたのですが、必要ないかもしれません。
もちろん今は普通に表示が遅い状態なので改善が必要なのは確かなのですが、そもそもの問題はリンクの数だけデータベースにアクセスしていたことにあるのです。
つまりキャラが200人いればアクセスは200回、遅くなるのも当然です。
そこで、データベースへのアクセスを減らすためリンク先の取得結果をキャッシュとして保存しておこうと考えたわけです。
しかしそうなるといつキャッシュを保存していつ更新するかが問題となります。
データベースの更新によってリンク先は変わる可能性があるのですから。
なので、リンク先は毎回調べることにするけれど、これをデータベースへの1回のアクセスでまとめて取得すれば体感的にはほとんど時間がかからないのです。
現実的には1回では済まないと思いますが、キャラの多いページではおそらく劇的に高速化可能だと思われます。

無題

アンパンマンDBのリンク先のキャッシュデータを作るということを考えてみました。
もともとアンパンマンDBの一部のページは表示が非常に遅いという問題があります。
原因はキャラクター名などのリンクを作るためにデータベースに対し非常に多くのアクセスを行うためです。
しかし、キャラクター名などに対するリンク先はあまり頻繁に変化することはないわけです。
そのため、リンク先をキャッシュデータとして保存しておけば一つ一つデータベースを参照しなくてもリンク先を知ることができる可能性があります。

隅隠し

時々マウスポインタが暴れて、右上に吹っ飛んでいったりします。
すると、右上には最大化したウィンドウの「閉じる」ボタンがあるわけです。
「上書き保存」ボタンを押そうとした瞬間に飛んでいくとえらい目に遭うわけです。
たいていのソフトは気を利かせて終了確認を出してくれますが、全てのソフトが気を利かせてくれるわけではありません。
なので、予期せぬ終了動作をなるべく防ぎたいわけです。
そのためには、単純には画面端をクリックできなくすればいいわけです。
しかし単にクリックできなくすると今度はクリックで閉じられなくなって不便なわけです。
なので、一度クリックすると一時的にクリック禁止を解除するようにすれば、意識的に閉じる場合にはダブルクリックすればよくなります。
こういう発想のソフトはたぶん探せばあるのでしょうが、作ったほうが早そうです。

無題

ナマライザ、読み込みながらURLデコードというのはしんどいので、とりあえず表示だけURLデコードに対応させてみました。
あと、docomoの検索ワードを拾えるようにしたいので、そちらに対応したら公開しようと思います。
検索ワードについては、いずれ検索ワードの解析方法をユーザー定義できるようにしたいと思っています。

無題

NeoMuplDLL初期化の方針。DirectShowとDirectMusicを使うと仮定して。MCIはまた対応はずすかも。

  1. バックグラウンドでDirectSoundを初期化。これは両方に必要。
  2. DirectShowとDirectMusicのどちらを先に初期化するか決める。デフォルトはDirectShowで、再生キューにDirectMusic使用曲が先に入っていたら順番を入れ替える。
  3. DirectShowを初期化。
  4. DirectMusicを初期化。

…としたいんだけど、メインスレッドと別のスレッドで初期化だけしてもいいのかな。
場合によってはアプリケーション本体用スレッドと再生専用スレッドに完全に分離するかも。

メテオスもどき

そんなわけで、アニメーションやリソース管理システムをいじりました。
これでマップを表示するときにアニメーションをコピーしまくってもメモリエラーを起こさないのです。
マップ表示自体は一から作り直すことになったのですが、流用を考えて中身をチェックしていたおかげで問題点がいち早く見つけられたように思います。
そんなわけで、明日からはマップ表示を一から作り直します。

こっそりメテオスもどきを作ってやろうかと画策中です。
遠からず終わってしまうメテオスオンラインに最後の光を与えることができるか、それともQに喧嘩を売ることになるのか、はたまた燃えカス1個ほども影響がないのか、わかりませんが、何か思い出に作っておきたいんです。

IIB

うむ、とりあえずインデックスカラー・インデックスカラー・ブレンド比率が並ぶデータだから、拡張子はiibにしようと思います。
ヘッダに必要そうな情報は、まず識別情報に、インデックスカラーに使うビット数、ブレンド比率に使うビット数、画像のサイズに、圧縮方式やパレット内の色の表現方法の識別コードも必要かな。
そして拡張ヘッダ。
ヘッダの次に来るのがパレットデータで、生の色の情報。
あとは決められたビット数で、インデックスカラー・インデックスカラー・ブレンド比率を最後まで続けて、必要ならば圧縮も。
うんうん。決まってきた。

ブレンディング

ふにゃさんのとげとげの拡張をするついでに、最後に一つ余ったキャラ枠をどう使うか考えてました。
順当なところで1アップか、あるいは取らなくてもいいけど取ったバナナの数にカウントされるボーナスアイテムか、それとも他のものにするべきか、そして決まったところで、アイテムの外観はどうするか、そのあたりが決まっていないのです。

それはそうと、画像フォーマットを一つ考えてみました。
インデックスカラーの長所で、パレットを差し替えれば画像全体の色が変えられたり、パレット番号何番は服の色、などと色に論理的な意味がつけられたり、そういうところを活かしつつ、なおかつたくさんの色を無理なく表現できてインデックスカラーの苦手そうなアンチエイリアシングもしやすい形式です。
まず、パレットは意味のある必要最低限の色だけを用意しておいて、画像本体には、どの色とどの色をどんな割合で混ぜ合わせるかのデータを入れるのです。
もしかしたら似たようなのが既にあるかもしれないのでまた調べてみます…。

本当の完成

ふにゃさんは今度の更新でかなりたくさんの部分を改良したり追加したりします。
それはもう、なんで今まで1年間以上も未完成を提供していたんだと思わせるほどに…したいのですが。
とりあえず、昨日の続きで、無重力状態での上下左右の接続はさすがにむちゃくちゃすぎるので廃止し、逆に場外負けを上方向にもつけるようにしました。
そして、キャラ絵をあんこ、サングラスをかけたふにゃの2バージョンを作ってオプションで変更できるようにしてみたりもしました。
あと、操作説明のところで、終了できなくなるバグを修正したつもりが、更に別の操作をするともっと悪い状態になってしまうことがわかったので、逆にどんな悪い状態になっても終われるように修正しておきました。
で、サングラスのことなんですが、サングラスをかけさせると黒背景のタイトルではサングラスが見えなくなるんですよね。
そこで、絶対に改悪にならないように、背景を黒以外にする方法を考えていると、デモプレイを背景に流すというのを思いつきました。
なんだか難しそうな気もしますが、しかし何とかできるような気もします。

1171033149.png

マップシステム作り直そうか

Bomber丸World、高さマップ廃止とかで、マップ構造にも変化が現れそうなので、いっそマップシステムをまた1から作り直すとして、やりたいことを考えてみます。

1.複数のマスにまたがるキャラを作れるようにする。
これ、当初主人公たちも2マス×2マスにしていて、つまり半歩ずつ歩けるようにしていたんですね。
ただ、実装の面倒さから再び1マスの大きさに戻したんです。
しかし、このゲームはかなり体格差のある人々が出てくるため、やっぱり主人公基準の1マスじゃ小さすぎるわけです。

2.高速な追跡アルゴリズムを実現する。
現在の次に探索すべき場所をすべて含む矩形内をくまなく調べる追跡アルゴリズムはマップの一辺を1として最悪でO(l3)の処理時間でしたが、次に探索すべき場所を記録しておいて調べるのは実際調べなければならない場所だけというアルゴリズムにすればO(l2)の処理時間に短縮することが可能なはずです。

3.エディタを利用することを前提としたファイル形式にする。
何しろアニメーションにせよキャラクターにせよテキストエディタで書いていること前提であらゆる省略記法を想定し、ファイル形式が複雑になってしまいました。
専用のエディタを作れば、データ量が増えてもあまり手間は増えないので、データ構造の単純化が実現でき、同時に作る人の頭も単純な考えで動かしてかまわなくなるのです。

ウィキウィキウェブ

突然ですが爆ボンバーマンWikiを始めました。
なんというか、メテオスWikiに触発されました。
とりあえずWikiにしときゃあ何かあるだろう的な考えの元、深く考えずに作ってみました。
Bomber丸Worldが完成したら、私の干渉しない、ユーザーの作る攻略ページをWikiで作れたらなぁと思い、その練習もかねて作ってみたわけです。

そんなBomber丸Worldのことですが、エンディング時の強さを保ったまま最初からゲームが始められるシステムというのはどうだろうと考えてみたりしました。
これがあれば裏ボスとかを滅茶苦茶強くしても10周目ぐらいに勝てるようにしておけば問題ないし、1回目は苦戦していたボスを楽勝で倒す快感も味わえるのです。

バリエーションデータの続き

で、バリエーションデータの、どのデータをどのタイミングで読み込むか、というのを考えてました。
Aという基本データと、Aと少し違うBのデータがあったとして、BにはAと同じ内容のデータは記載せずに、Aとの関連と差分のみを記録するという方式でデータを扱うのがバリエーションデータなのですが、記録するほうはそれでいいとして、Bを読み込むときにはどうすればいいのか、という問題があるわけです。
基本となるAを読み込むならただ読み込むだけでいいのですが、Bを読み込むとき、同時にAをも読み込む必要はあるのか、ということです。
同時にAを読み込んで初めから完全なBのデータを用意しておくのはプログラム的にも簡単なのですが、例えばBがAとほとんど違っていた場合や、Aから派生したBから更に派生したCからまた派生した……Zなんてデータが来た場合、Zには最早Aの面影は残っていなくて、YやXまでさかのぼれば充分な場合、そもそもデータを参照する回数が少ない場合など、つまり、さかのぼりがあまり頻繁には起こらない場合などには、いちいち全部用意していると読み込み負荷ばかりが余計にかかる可能性が高いわけです。
もちろん現実的にはさかのぼるのはせいぜい5回程度までのはずなので、そんなに神経質になる必要は無いのでしょうが、auto_resourceとの相性なども考えていきたいのです。
先程とは逆にBを読み込んだときにAを読み込まない方式としては、Bのデータを参照して、該当するデータが無かったときにそのつどAを読み込んで該当するデータを探す方法を考えています。
当然のことながら性質も逆で、さかのぼりが少なければ少ないほど、効率的になります。
とりあえず前者をA方式、後者をB方式と呼ぶことにすると、基本データよりも派生データが圧倒的に多いときのメモリ効率で考えた場合、A方式だと末端に行くにつれてデータが追加されるので、メモリ消費が多くなりがちですが、逆にB方式では本当に最小限のメモリ消費しかないはずです。
とにかく、データの性質によってかなり変わりそうではあります。

バリエーションデータ

Bomber丸Worldの最初に表示される画面、すなわちよく言われるところのタイトル画面について考えてみました。
最初の予定では、2002/10/05(Sat)の日記や、2003/11/19(Wed)の日記で書いていたように、普通にタイトル画像を用意しておいて、それをドカンと出す方式にしようかと思っていたのですが、どうにもこの方式だとまず画像が必要だし、タイトルからゲームに入るところのインターフェイスをどうするかに迷うし、なんとなくだけど「らしくない」気がしたりするので、よくある正攻法のタイトル画面とは違う方式にしてみようと思いました。
そこで考えたのが、ゲーム画面を最初から出しておくという方式。
具体的に言うと、タイトル画面用のマップを用意しておいてそこを自由に動き回れるようにしておいて、マップ内にある特定のオブジェクトを調べることで実際にゲームが開始されるようにします。
もちろんタイトル画面というからにはタイトルも表示しなきゃいけませんが、マップ上にタイトルを表示するのは別に難しくないと思うのでこの方法で検討してみようと思います。

そして、データをXMLとかで管理しようと考えていたのですが、目的から考えるとやっぱりXMLである必要はなさそうに思えてきました。
Bomber丸Worldに必要なデータは、多重に階層化されていて、それぞれの階層にはデータがあって、末端の階層にあるべきデータを参照して該当するデータがその階層に無ければ上位の階層に該当するデータが無いか見に行き、あればそのデータを使うという、すなわち、もっとわかりやすく例で言えば、例えば、「カイモチ民であるふにゃが困った顔をしているとき」の歩くスピードを調べたいとき、「困った顔」というのには困った顔のデータしか無くて、歩くスピードがわからないので「ふにゃ」の歩くスピードを見に行くんだけれどもふにゃの歩くスピードが標準的なカイモチ民と変わらないから特には設定されてなくて、最終的に「カイモチ民」まで見に行って、最終的には「カイモチ民であるふにゃが困った顔をしているとき」の歩くスピードは「カイモチ民」の歩くスピードとして得られるわけです。
これを使えば何がうれしいかというと、ほとんど同じだけど一部が少し違うようなデータを簡単に作れるんです。
オブジェクト指向とかがわかる人ならクラスの継承のようなもの、といえばわかるでしょうか。
詳しい実装方法は後で考えることにします。

IDの数値

TGscriptのIDをどうするか考えていました。
例えばIDをファイル名として記録していた場合、不正利用者がLinuxのコマンドをIDの代わりに送信してきた場合に非常にまずいことになるのです。
ですから通常CGIなどでは外部からの入力をそのままファイル名として開くようなことはしません。
しかし今回はたくさんあるかもしれないIDをファイル名として扱ったほうが非常に都合がいいと思われるのです。
そこで、IDを数字にすることで、コマンド実行をできなくすることにしました。
もちろん数字じゃなくてもコマンド実行をできなくすることは簡単ですが、ID生成のとき乱数をそのまま使えたり、IDに使われる文字の種類が少ないというだけでも充分に意味はあります。
さらに、ID偽装防止のためのキーも用意したりしました。
もっとも、ID偽装防止のキーを使うのはIDを使って悪さができる段階、つまり書き込みのタイミングのみですが。

auto_resource実装案

Bomber丸Worldのリソース管理システム(auto_resource)のメモリ管理を考えていました。
メモリ確保のほうはshared_resourceと同じで全く問題ないのですが、メモリ解放が問題なのです。
メモリ確保をしていくうちにメモリが足りなくなったら最近使われていないものからメモリを解放していくのですが、その実装方法がいくつかあって、どれを選ぶべきかというのが難しかったのです。

考えている方法は三つあって、一つ目はその時点で使われていなければ新しかろうと古かろうと片っ端から全て解放してしまうというものです。
解放の際には全てのリソースが入っているコンテナの中身を全て走査して参照カウントが0のものを全て解放します。
この方法は最も実装が簡単で消費メモリも少なくなりますが、一時的に使わなくなったりソースを後のために取っておくというauto_resourceの考え方に反してついさっきまで使っていてまたすぐ使うかもしれないものまでどんどん解放していってしまいます。
マップ切り替えなどで一度に大量のリソースを読み込んで解放する場面ではすごくまずいことになります。

二つ目の方法は、字面通り最後に使われた時間が一番古いものから順番に解放してゆく方法です。
これを現実的な処理時間で実現しようと思えば、リソース参照用のファイル名-リソースを関連付けたマップのほかに、今まで使った順番に並べられたリストが必要になり、必然的にリソース本体とは別の余計なメモリが必要になります。
更にリソース側にも、解放や順番の並び替えの高速化のためにリストやマップへのイテレータが必要になります。
リストの実装によっては更に難しいコーディングが必要になるかもしれません。
そして当然、使用するたびに使用時刻の更新やリストの並び替えが発生するのでパフォーマンスは低下します。
ファイル読み込みによるパフォーマンス低下を嫌ってauto_resouceを作ろうとしたのに全く逆効果の可能性すらあるのです。
解放の際にはリストの末尾から順番に見て行って規定のメモリ以内に収まるか全て走査し終えるまで参照カウントが0のものを解放していきます。

三つ目の方法は、上記二つの中間を取って、ある時間より古ければ数が多かろうと少なかろうと全部解放してしまうという方法です。
これであれば、一つ目の方法ほど無駄は出ませんし、順番を考える必要が無いので二つ目の方法のようにリストを保持しておく必要がありません。
解放の際には適当にしきい時刻を決め、全てのリソースが入っているコンテナの中身を全て走査して参照カウントが0かつ使用時刻がしきい時刻より古い場合には解放します。
これの問題点は、しきい時刻の決め方やリソースの使用状況によって著しく性能が変化するということです。

それぞれ長所と短所がありますが、まず一つ目の方法は通常時には問題外ですが終了時に全てのリソースを解放する必要があるときには効果を発揮します。
二つ目はリソース自体の消費メモリが大きかったり使用するときの実行時間が長いなど、欠点が問題にならないほどスケールの大きいものであれば相対的に長所のみが残って最善の手段となります。
三つ目は二つの中間的なものなので無難としかいえません。
そんなこんなで、三つとも実装してみる価値はありそうです。

GChatの管理画面の改良を行いました。
まず、辞書画面での検索機能です。
これにより辞書への重複登録ということは少なくなったはずです。
そして、なぜか今までずっと実装していなかった全ログ確認機能。
これでもう直接ログファイルを見る必要はなくなったのです。
そんなこんなでアルニックもレベル29になりました。
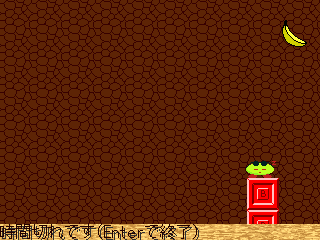
XMLパーサ試作型

Bomber丸Worldに使うデータの一般的な書式について考えています。
アニメーション定義ファイルにせよキャラクター定義ファイルにせよ、省略記法により手作業の手間を省くつもりが却って全体の見通しが悪くなって様々な問題を引き起こしてるんですね。
融通の利かない仕様でデータ一つ一つに対して新たなプログラムを作り直す必要があるし、手作業を前提としたファイル構造のためプログラムでの生成が難しくなったりもしました。
そこで、融通が利き、拡張性が高く、なおかつゲーム向き、そういうのがほしくなったわけです。
で、とりあえず一つのアルゴリズムでいろんなデータを読み込めて、わりと自由に要素を作れるXMLというものに着目してみました。
特定用途に使うものであり、なおかつ専用ソフトを使って編集する可能性が高いということで、読み書きに都合の良いように独自のアレンジを加えるというのもありかもしれません。
タグの管理は、同じタグがいくつもあるということもありうるのでmultimapで管理するとよいでしょうか。
もっとも、XMLのような考え方を使うとすると、正確にXMLである必要が無いどころか、実際が全くXMLからかけ離れた内容でも大きな問題はなく、初めから専用エディタでのみ作るという前提にすれば、バイナリ形式で構造的にXMLのような、というのもありかもしれません。

<前 次>