アンパンマンDB(システム)
先日からCSV出力関連の機能を作っていたわけですが、普通の人はCSV出力機能なんかあったって使わないわけじゃないですか。
一方で管理人の私は、できるだけ多くのページでCSV出力に対応させたいと考えていまして。
今のところ、個別DBの検索結果では、設定を変更すればCSV出力のリンクを表示できるようになっています。
この仕組みをうまく全体に適用できれば、必要な人だけCSV出力機能に便利にアクセスできるようになると思うんですよね。
このあたりのこと、今ちょっと考え中です。
アンパンマンDB(システム)
コメントのルールは、込み入ったものはハードコード、単純なものはデータベースに登録しているんですが、データベースに入れているほうのコメントルールの管理画面を作りました。
単純とはいっても、文面を動的に変えられないだけで、どういう場合に出すかとかは結構柔軟に指定できて、現在は最新映画のページに出ています。
管理画面向けのルールも同じように編集できるので、変なコメントへの対応がもうちょっとスピーディーになるかと思います。
アンパンマンDB
アンパンマンDB(みんなのタグ)
とりあえず出来上がったのでリリースしました。
アンパンマンDB(システム)
画像周りでちょっとおかしなことになっていたので、修正しました。
そんでもって、この機会に画像周りの自動テストも整備しました。
アンパンマンDBとNeoMupl
アンパンマンDB(システム)
画像表示を刷新しました。
5月にやってたのがやっといい感じのところまでできてきたので。
画像形式をJPEGより小サイズなWebPにしたのと、画像IDをランダム文字列化しました。
実は古い画像は微妙に法則性が残っていたりしますが、そのへんはあまり気にしない方向で。
もしかしたら古いブラウザで表示できなくなるかもしれませんが、そんな古い環境知ったこっちゃないです。
NeoMupl
自分で使ってて気になったので、課題立てました。
再生停止後に、停止する直前の状態のまま残ったり、状態がリセットされたりして、統一感がなくて気持ち悪かったんですよね。
アキタラヤメル[ポジティブ不老不死さん]とアンパンマンDBとTgwsMark
アキタラヤメル[ポジティブ不老不死さん]
サーバーが変わってPerlCGIが動かなくなって長らく放置されていましたが、復活しました!
いえ、不老不死なんで死んでないんですが、コンテンツとして復活しました!
一応今のサーバーにも別バージョンのPerlが入ってるっぽいんですが、もうほとんど覚えていない言語で今更別バージョンに合わせた大規模改修をする気力もないので、PHPで全面的に書き直しました。
アンパンマンDB(システム)
ペアリストもCSV出力対応しました。
通常のリストの表記に加え、「=」で左辺と右辺を繋いでいます。
TgwsMark
README更新しました。
使い方やら文法やらを書いています。
完全に網羅ってわけじゃないんですが、主に使う部分についてはまあまあ書けた感じです。
アンパンマンDBとTgwsMark
アンパンマンDB(記事更新)
亡くなったことに伴う更新です。
アンパンマンDB(システム)
CSV出力機能調整しました。
まず、リスト項目をHTMLからもうちょっと見やすい形式に変更しました。
管理画面での表記と同じく、改行区切りでの表記となります。
表示とリンク先が違えば>で右にリンク先表示。
本来と別の個別DBへリンクしている場合、:の左に表記。
注釈は通常ページでの見た目通り、()に囲んで表記。
まあ、見やすいとはいっても、もともと複合的なデータなので、CSVに入れるにはちょっと複雑になっています。
それと、これはCSV以前のバグだったんですが、管理人による記事更新直後に検索を行うと、更新前のデータが検索キャッシュとして保存されるバグがありました。
そのため、検索画面と、その結果を使うJSON/CSV出力では、次の更新までずっと古いデータが表示されていました。
これが今まで問題にならなかったのは、記事更新時には更新した記事そのもののキャッシュを真っ先に更新していて、最新記事だけは更新後のデータで検索キャッシュが作られていたからでした。
これがなぜCSV出力のときに問題になったのかというと、CSV出力内容の変更に伴う内部データの変更もキャッシュされており、ずっと変更前の内部データが使われていたからでした。
ということで、古いデータをキャッシュに使わないという方向でこれを修正したというわけです。
TgwsMark
具体的な作業はしてないけど、課題だけ立てときました。
貴方が作ってプルリクしてくれてもいいんですよ。
アンパンマンDB(システム)
個別DBの検索結果のページに、CSV出力機能をつけてみました。
まだ実装途中なので変なCSVが出がちですが、どうせ設定をいじるかURLを直接指定するかでしか出てこない機能なので、未完成のやつをすでに公開しています。
https://tgws.plus/anpandb/anime?search=&sort=-access&view=csv
アニメDBに限って言えば、アニメエピソードCSVダウンロードもあるのですが、そっちは基礎情報だけで、目的や機能がちょっと違うやつです。
アンパンマンDB(システム)
新ストリクトクエリの実装、何とか完了しました。
昨日の時点でリストとペアリストの内部実装を刷新できたので、あとはこれを適用するだけだと思ったのですが、思いのほか難儀してしまいました。
文字の正規化の扱いが一貫していなくて、正規化すべきところで正規化されなかったり、逆に正規化しすぎたりというのが一つ。
一応、正規化には冪等性があるので、正規化しすぎに関しては無駄以外の実害がないのですが、正規化ができていないと、一致するものも一致しなくなります。
それから、検索の高速化のために、結果をキャッシュしておく機能もあるのですが、キャッシュが効きすぎて、新ストリクトクエリ未実装のころの結果をいつまでも返していたというのも一つ。
これに気付かず、正しいSQLを長いこと調査続けてました。
ほかにもいろいろ細かい理由はあったのですが、大きなのはこのくらい。
エイリアスと個人メモに関しては、検索の前処理で特別扱いするだけで、検索の中身は何も特別ではないので、普通の文字列検索と同じように簡単に実装できました。
アンパンマンDB(システム)
リストとペアリストの内部実装、新ストリクトクエリに対応可能な形に修正完了しました。
これにより仕様が微妙に変わってしまいましたが、実用上大きな差は現れないのと、新ストリクトクエリで同じことを再現できるようになる予定なので、まあこれで良しとしておきます。
やっとリストとペアリストの新ストリクトクエリ実装のスタートラインに立てました。
アンパンマンDB(システム)
リストとペアリストのストリクトクエリ、旧仕様を当面残すため、内部仕様を変更しても影響を受けにくい仕組みを作っていました。
この仕組み、将来的には新仕様に一本化するタイミングで消すことになるんですが、これやっとかないと新仕様の実装が面倒になりますからね。
で、この2つを同時に作業進めているのには訳があって、まあ想像はつくと思うんですが、内部的には似たようなことをやっているんですよね。
リストは単に文字列のリスト、ペアリストはA→Bみたいな文字列の組み合わせのリストで、検索では、それぞれの文字列に対して検索をかけられるだけでなく、アンパンマンDB内のどの記事にリンクしているかでも検索できます。
「登場作品を探す」で使っている検索ですね。
これ、まあまあ無理やりな感じで共通化しているのですが、新仕様ではもうちょっといい感じに共通化しようかと思っています。
アンパンマンDBとPHP-CS-Fixer
アンパンマンDB(システム)
リストの現行のストリクトクエリのテストを作成。
新記法にする前に、内部処理を変える必要があって、旧記法でも同じ内部処理を使う必要があるので、内部処理を変えても旧記法が通用することを確認するためのテストが必要なのです。
PHP-CS-Fixer(Today I Learned)
PHP-CS-Fixer/PHP-CS-Fixer: A tool to automatically fix PHP Coding Standards issuesには、ドキュメントコメントでもないくせにドキュメントコメントぶっているただのコメントを本当のただのコメントに戻す機能があります。/** ただのコメント */→/* ただのコメント */
しかし、/** @var ADBValueList $adb_value */みたいに、ローカル変数の型を指定しているコメントまで、ただのコメント扱いされてしまいます。
Intelephenseでは、ちゃんとローカル変数のドキュメントコメントも認識してくれるので、PHP-CS-Fixerにぶち壊されると困るのです。
そこで使うのが以下のオプション。
Rule phpdoc_to_comment - PHP Coding Standards Fixer
ドキュメントコメントをただのコメントに戻す処理の制御ができます。
今回の件なら、ignored_tagsオプションにvarを入れれば、@varのドキュメントコメントだけは見逃してくれるようになります。
アンパンマンDB
アンパンマンDB(システム)
ストリクトクエリの新記法、リストとペアリストの件が全く進まないまま、エイリアスと個人メモが手付かずなのが発覚しました。
それはそうとして、画像のシステムを変更することを考えていて、ファイル名のつけ方をいい感じに思いついたので、試しに実装してみました。
まだ全面的に適用しているわけではないので、一般ユーザーに見える場所では登場はしていないのですが。
アンパンマンDB(みんなのタグ)
これまで新機能を実装するたびに「プレビュー1」から数字を上げてきていたのですが、毎度毎度これをやっていると細かい改良がだるくなるので、「プレビューN」で一本化しました。
もう細かい機能実装は事前にも事後にも告知なく随時リリースしていきます。
プレビュー版って本来そういうことですからね。
あと、みんなのタグの管理強化の準備の実装の準備を実装したりして、管理機能自体は別にまだ強化してません。
アンパンマンDB(システム)
ストリクトクエリの新記法、単に冗長な記述を取り除くだけの形で、エイリアス、真理値(ON/OFF)、択一カテゴリ、複数カテゴリ、日付、数値、読みを対応しました。
残るは、リスト、ペアリストだけです。
この2つは、結構大きめな拡張を予定していて、旧記法を当面の間残すことを考えると、旧記法も中身を新記法と同じにする必要があります。
この辺りはさすがにちょっと大変になるかも。
あと、新記法の対応が完全に終わってからになりますが、ストリクトクエリの説明ページも作ろうかと思っています。
アンパンマンDBとドラゴンクエスト10
アンパンマンDB(システム)
ストリクトクエリの件、みんなのタグ、一行テキスト、複数行テキスト、タイトル、商品単体リンクの項目について、実装完了しました。
旧ストリクトクエリも当面の間は使えるようにしますが、使われてなさそうなら一定期間後にこっそり廃止します。
これで残るは、エイリアス、真理値(ON/OFF)、択一カテゴリ、複数カテゴリ、日付、リスト、ペアリスト、数値、読みだけとなりました。
…いや、多いな。
ドラゴンクエスト10
魔法の迷宮ボスモンスター「タイムマスター」登場! (2024/5/2)|目覚めし冒険者の広場
タイムマスター実装!
『おでかけ超便利ツール』タイムマスターリリース記念スペシャルキャンペーン! (2024/5/2) |目覚めし冒険者の広場
タイムマスター実装記念!
キャンペーンはタイムマスターと関係ない福引にも適用されるので、お出かけ便利ツール福引引きました。
今回は、リースブランコプリズムとしぐさ書・怒り心頭が当たりました。
写真撮っときゃよかったな。
アンパンマンDBとFNチェンジャー2
アンパンマンDB(システム)
ストリクトクエリ、独自実装の方向で作ってます。
「:」で分割する方向性はそのまま。
分割内容に「:」を含みたい場合は、「\」でエスケープ。
分割内容に「\」を含みたい場合も、「\」でエスケープ。
例えば、「#test:test」を検索するストリクトクエリは、「user_tag:+:test\:test」になります。
エスケープしていない場合は、正しく解釈できないので、「user_tag:+:test:test」は無効です。
この分割ルールは早々にできましたが、分割結果をどう使うかっていうのは項目の種類ごとに実装が必要なので、そっちはまた追々ということで…。
FNチェンジャー2
今更ながら、ウィンドウ最下部についているプリセットの読み書きUI、何の説明もないのでわかりにくい気がしてきました。
自分用ツールなので分かりにくくても私には支障はないのですが、仮にもみんな向けに公開しているわけですから、一応改善はしておいたほうがいい気がしてきたので、課題立てておきました。
実はこう見えてOSSなので、コントリビュートしたい人は作ってみてもいいんですよ。
アンパンマンDB(システム)
ストリクトクエリの件、区切り子じゃないコロンをどうするかでちょっと悩んでます。
str_getcsvは区切りとして扱わない区切り子を考慮してくれますが、そのためには「"」など囲み記号が追加で必要になるんですよね。
単なるCSV(ここではCharacter Separated Values)であればそれでいいんですが、アンパンマンDBの検索構文では、ルーズクエリ・ストリクトクエリ両方に共通する文法で、スペースや「"」を含む単語は「"」で囲むという仕様があって、クオートの仕様がぶつかってしまいます。
一応ぶつかったところで、どちらにもエスケープ処理はちゃんとあるので、「"」で囲んだものを「"」でエスケープして「"」でさらに囲むみたいなことをすれば、不具合なく取り扱えるはずですが、ちょっとさすがにややこしいかなと。
ストリクトクエリの囲み記号を「"」以外にするか、そもそもstr_getcsvを使わずに完全に独自仕様にするか…。
あと、ストリクトクエリをパースするのとは逆に、ストリクトクエリを構築する機能もアンパンマンDBにはあるんですが、str_getcsvの逆をやる関数が実はPHPには今ないんですよね。
CSVの構築にはfputcsvがありますが、これはファイルに出力されてしまいますし、末尾に余計な改行も追加されます。
多分どうにかする方法はあるとは思うのですが、そこまでしてPHPの標準関数使うべきかな…と思ったり。
やはり独自仕様にする…かなぁ。
アンパンマンDBと日記
アンパンマンDB(システム)

善は急げで+-つけてみました。
しかしこうして見てみると、一行が長くなって折り返された時の見せ方にまだ改良の余地がありそうですね。
関係ないですが、検索のストリクトクエリもいくらか改良を考えています。
一般ユーザーにも教えている範囲では、みんなのタグの「user_tag:user_tag:○○:○○」があるんですが、最初の「user_tag:user_tag」の部分が見るからに冗長ですね。
本当は最初のトークンと次のトークンは意味が違っていて、最初が項目名、次はそれをどう扱うかというインターフェース指定なんですが、みんなのタグを含め、インターフェースを複数持つ項目はないから、実は項目ごとにインターフェースはすべて固定なのです。
なので、この冗長性を排除したいというのが一つ。
第二に、これは実用上ほぼ問題ないんですが、「○○」の部分にコロンを入れられないという地味な問題もあります。
あと、第三として、リスト項目をより細かい条件で検索できるようにするといった、純粋なグレードアップもしたいところですが、ストリクトクエリのトークン数は現状固定なので、まあまあ難しいのが現状です。
このあたり、第一の冗長性は当然廃止するとして、第二・第三の問題は、str_getcsvを使えばいい感じにトークンに分解できると思うので、これでトークン数可変で処理するようにすれば、まとめて解決できるんじゃないかと思っています。
日記
たまーに無題のまま日記投稿しちゃうことあるので、投稿前に無題チェックを入れるようにしてみました。
シンプルにJavaScriptで題を判定してconfirmしています。
アンパンマンDB(システム)
昔のアンパンマンDB(アンパンマンDB3)では、編集画面でプレビューすると、どの項目が編集されたか、編集内容を編集前と編集後で比較表示できるようになっていました。
しかし、今のバージョン(アンパンマンDB4)になって、項目の取り扱い方が大きく変わったため、比較表示機能は失われてしまいました。
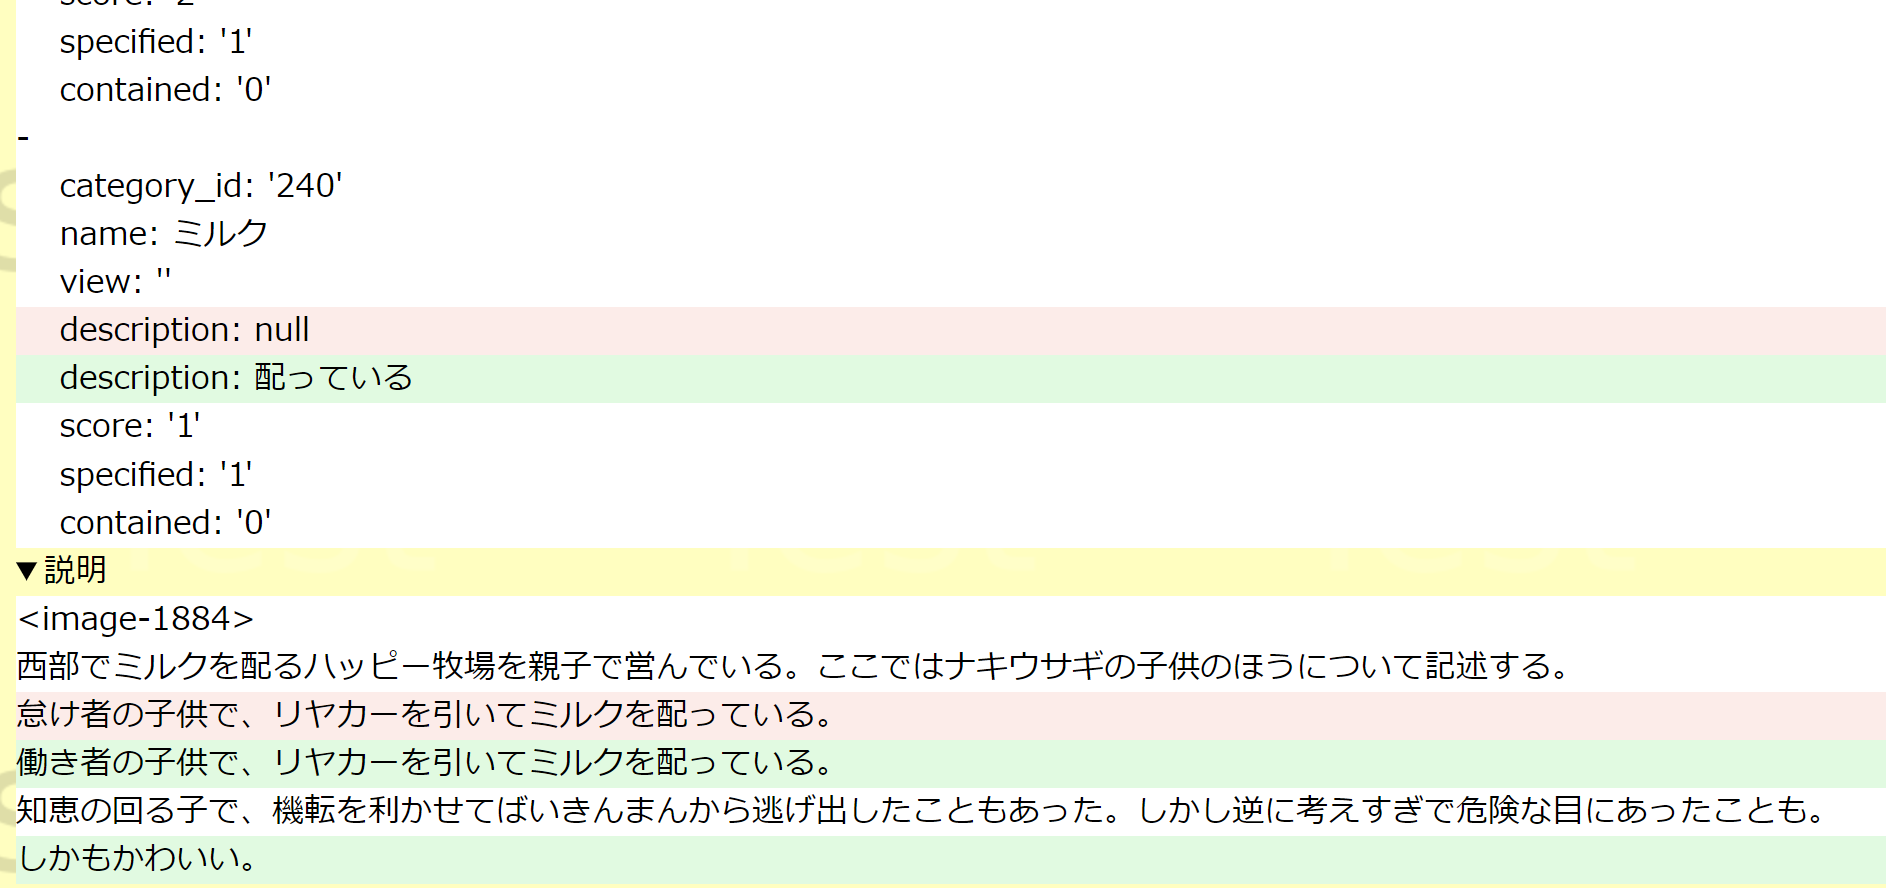
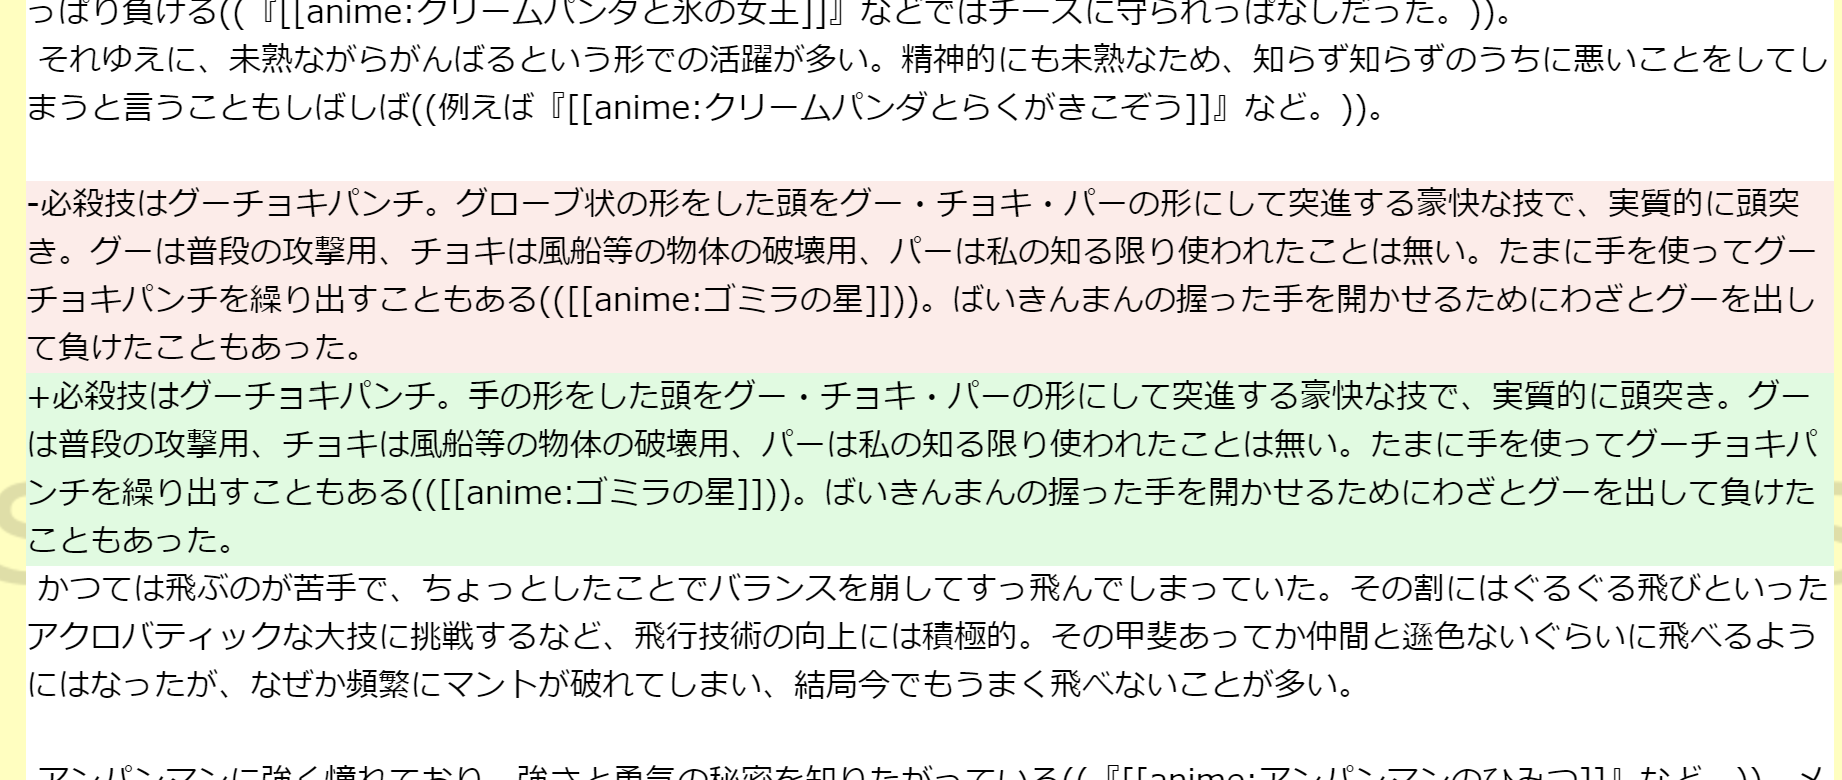
復活させました。
今回、編集内容の表示機能を復活させるに当たって、以前より見やすくしてみました。
編集前後を並べるのではなく、diffコマンドみたいに差分のあった行を色分けして強調表示しています。
欲を言うならもっとdiffコマンドに寄せて、追加行に+、削除行に-をつけたりするとかあってもよかったかもしれないですね。
これを作るに当たって使ったライブラリは、編集データの文字列化に使うsymfony/yamlと、できた文字列の差分表示に使うsebastian/diffの2つ。
差分表示のほうははJavaScriptでやっちゃおうかなとか思ってたんですが、しっくりくるものがなかったので、結局どっちもPHPでやりました。
symfony/yamlは、構造化されたデータを複数行のわかりやすくdiffの取りやすい文字列に変換(シリアライズ)してくれます。
diffを取りやすいというのがポイントで、JSONだと配列の要素の後ろ(または前)にコンマがつくかつかないかが要素の順序で変わったりして、実質変化のない行まで差分になってしまうのですが、YAML形式だとそういうのが起こりにくくなっています。
ただし、構造化されていないただの文字列を渡すと、JSON形式の一行の文字列にまとめられてしまうので、この場合だけはシリアライズ処理をせずにそのままdiffに渡します。
sebastian/diffは、おそらくPHPUnitにも使われている、行単位の差分検出ライブラリです。
シンプルに使えば、一発でいい感じのdiff文字列を出してくれるのですが、HTMLページに表示するにはdiff文字列ではちょっと都合が悪いので、配列形式のデータを一度出してもらって、そこから自力でHTMLを作るようにしています。
差分行の色は、GitHubと同じ色にしました。
アンパンマンDB(システム)
コメント周り、データベースからとってきたままの連想配列で持ちまわしていて、ちゃんとしたコメント用の型がなくて不便だったので、新たに型を作っています。
既存のシステムは連想配列前提で組まれているのでそれを新しい型に置き換えていくのは、それはそれでしんどいのですが、できてしまえばだいぶ扱いやすくなる予定です。
内部的な処理の都合なので、一般ユーザーにとっては特に変わらないですけどね。